A publicação dos pesos e do relatório técnico do DeepSeek-V3 e DeepSeek-R1 consolidou um ponto de inflexão irreversível na indústria de inteligência artificial: a demonstração de que modelos de fronteira com capacidades de raciocínio de nível de doutorado podem ser treinados e executados a uma fração ínfima do custo de infraestrutura dos pioneiros fechados.
1. A Topologia Mixture-of-Experts (MoE) de 671B Parâmetros com Ativação Esparsa
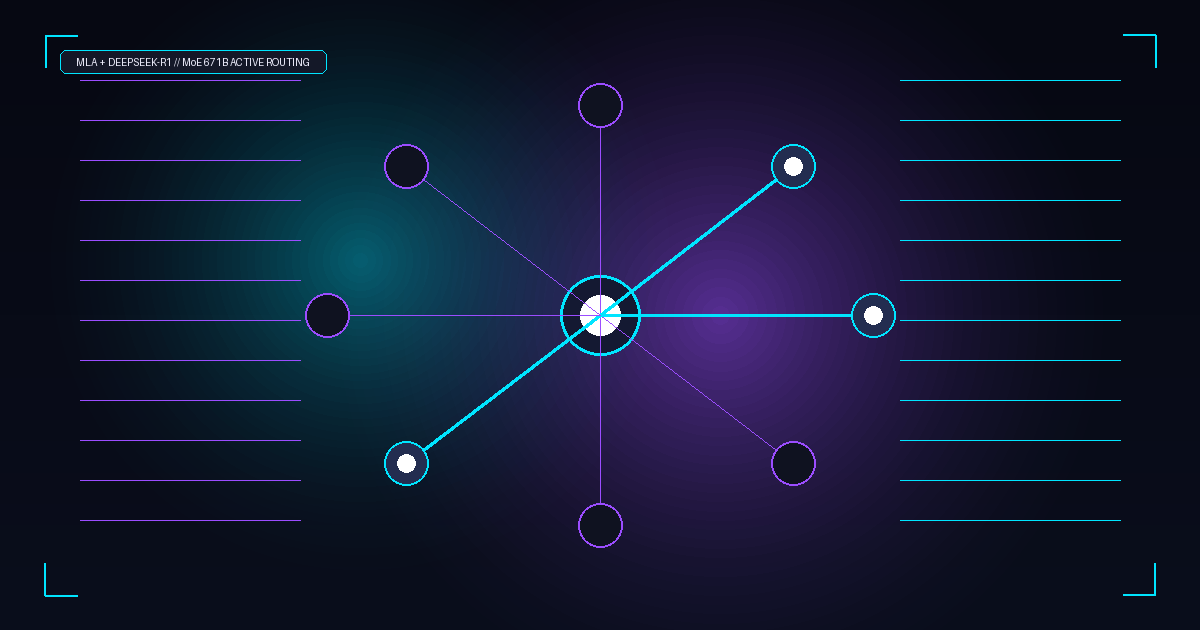
Diferente dos transformadores densos tradicionais, onde cada token mobiliza a totalidade dos pesos da rede durante a inferência, o DeepSeek-V3 adota uma arquitetura esparsa de 671 bilhões de parâmetros totais, na qual apenas 37 bilhões de parâmetros são ativados dinamicamente para cada token.
Essa esparsidade é orquestrada por uma camada de roteamento sem perda de balanceamento de carga (Auxiliary-Loss-Free Load Balancing). Ao eliminar a função de perda auxiliar clássica no roteador — que historicamente degradava o desempenho de modelagem linguística ao forçar especialistas arbitrários —, a arquitetura garante que a especialização semântica de cada especialista (Expert) atinja seu potencial máximo sem saturar nós de computação GPU.
Eficiência de Cache e Throughput: A introdução da atenção latente multi-cabeça (Multi-Head Latent Attention - MLA) comprime a chave e o valor do KV Cache em um espaço latente de baixa dimensionalidade, reduzindo a pegada de memória do KV Cache em 93,3% em comparação com o Multi-Head Attention (MHA) padrão. Isso permite janelas de contexto de 128k tokens com custos computacionais viáveis para empresas.
2. Treinamento por Reforço Puro: O Algoritmo GRPO sem Reward Models
O grande avanço teórico do DeepSeek-R1 é a emergência de comportamentos de raciocínio profundo (Aha moments, auto-correção, backtracking e reflexão metacognitiva) através de Pure Reinforcement Learning, dispensando a fase massiva de Supervised Fine-Tuning (SFT) que caracterizava os pipelines convencionais.
Em vez do clássico PPO (Proximal Policy Optimization), que exige a manutenção concorrente de um modelo de política, um modelo de valor (Critic) e um modelo de recompensa (Reward Model), os pesquisadores desenvolveram o Group Relative Policy Optimization (GRPO). O GRPO amostra um grupo de respostas candidatas para cada prompt e calcula a recompensa relativa normalizada dentro do próprio grupo, reduzindo drasticamente o consumo de VRAM e estabilizando a convergência em domínios matemáticos e de código.
3. Soberania Corporativa: Rodando Modelos de Raciocínio On-Premise
Para empresas dos setores financeiro, de saúde e de infraestrutura crítica, a existência de pesos abertos de classe mundial como o DeepSeek-R1 e suas versões destiladas (baseadas em Qwen e Llama de 1.5B a 70B parâmetros) remove a dependência cega de APIs de hiperescaladores norte-americanos.
Na Better2Better, implementamos pipelines de inferência quantizada utilizando vLLM e SGLang com suporte a quantização FP8 nativa. Essa abordagem permite que corporações processem contratos sensíveis, realizem auditoria de código e automatizem processos regulatórios com conformidade total à LGPD e soberania de dados inegociável.
4. Tabela Comparativa de Arquitetura e Custo de Inferência
| Métrica / Arquitetura | Modelo Denso Legado (175B) | MoE Proprietário Fechado | DeepSeek-V3 / R1 (Aberto) |
|---|---|---|---|
| Parâmetros Ativos | 175B (100%) | Estimado ~50B | 37B (Esparso) |
| Pegada do KV Cache | Alta (MHA padrão) | Média (GQA) | Ultra-Baixa (MLA Latente) |
| Método de Raciocínio | SFT + PPO com Reward Model | Incentivo por SFT Fechado | GRPO Puro + Destilação |
| Soberania de Implantação | Apenas Nuvem Própria | API Restrita | On-Premise / Bare-Metal / Nuvem Soberana |
5. Referências Acadêmicas e Fontes Técnicas
Citações Científicas e Whitepapers:
- DeepSeek-AI Team (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948 [cs.CL].
- DeepSeek-AI Team (2024). DeepSeek-V3 Technical Report: Architecture, Training and Alignment. arXiv:2412.19437 [cs.CL].
- Shao, Z., Wang, P., Zhu, Q., et al. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv:2402.03300.
- Schulman, J., Wolski, F., Dhariwal, P., et al. (2017). Proximal Policy Optimization Algorithms. arXiv:1707.06347.
Garantia de Segurança e Auditoria Criptográfica em Agentes de IA
Implantar modelos preditivos e agentes sem uma camada de segurança defensiva é o maior risco operacional que uma empresa pode correr. Na Better2Better, nossa equipe liderada por Felipe Siqueira e a Dra. Helena Vance realiza uma revisão arquitetural profunda do seu sistema, auditando pipelines de prompt injection, isolamento de memória vetorial em sandboxes gVisor e execução em enclaves criptografados.
O que podemos fazer por você hoje?
Gostou do conteúdo? Crie seu ecossistema de agentes autônomos de IA com blindagem de segurança militar e auditoria garantida clicando aqui!
🤖 Criar Ecossistema de Agentes de IA via WhatsAppGarantia de Segurança e Auditoria Criptográfica em Agentes de IA
Implantar modelos preditivos e agentes sem uma camada de segurança defensiva é o maior risco operacional que uma empresa pode correr. Na Better2Better, nossa equipe liderada por Felipe Siqueira e a Dra. Helena Vance realiza uma revisão arquitetural profunda do seu sistema, auditando pipelines de prompt injection, isolamento de memória vetorial em sandboxes gVisor e execução em enclaves criptografados.
O que podemos fazer por você hoje?
Gostou do conteúdo? Crie seu ecossistema de agentes autônomos de IA com blindagem de segurança militar e auditoria garantida clicando aqui!
🤖 Criar Ecossistema de Agentes de IA via WhatsApp