El razonamiento híbrido configurable (Hybrid Reasoning with Extended Thinking) en Claude 3.7 Sonnet ha inaugurado un nuevo estándar en el desarrollo de software empresarial. Por primera vez, los equipos de arquitectura pueden regular mediante API el balance entre respuestas en milisegundos y computación reflexiva profunda con decenas de miles de tokens de pensamiento interno.
1. La Dualidad del Cómputo en Tiempo de Inferencia
Anteriormente, los desarrolladores debían elegir entre modelos rápidos para tareas interactivas o modelos lentos y costosos para análisis lógicos de alta dificultad.
Claude 3.7 Sonnet unifica ambas funciones bajo un mismo motor. Mediante el parámetro de presupuesto de pensamiento (Thinking Budget), es posible obtener respuestas instantáneas para consultas habituales o asignar hasta 64.000 tokens de razonamiento interno para resolver condiciones de carrera, refactorizar arquitecturas monolíticas o auditar smart contracts.
Efectividad en Resolución de Código: En pruebas internacionales como SWE-bench Verified, la asignación de pensamiento extendido supera el 70% de éxito en la resolución autónoma de problemas reales de ingeniería de software.
2. Dinámica de los Tokens de Pensamiento Interno
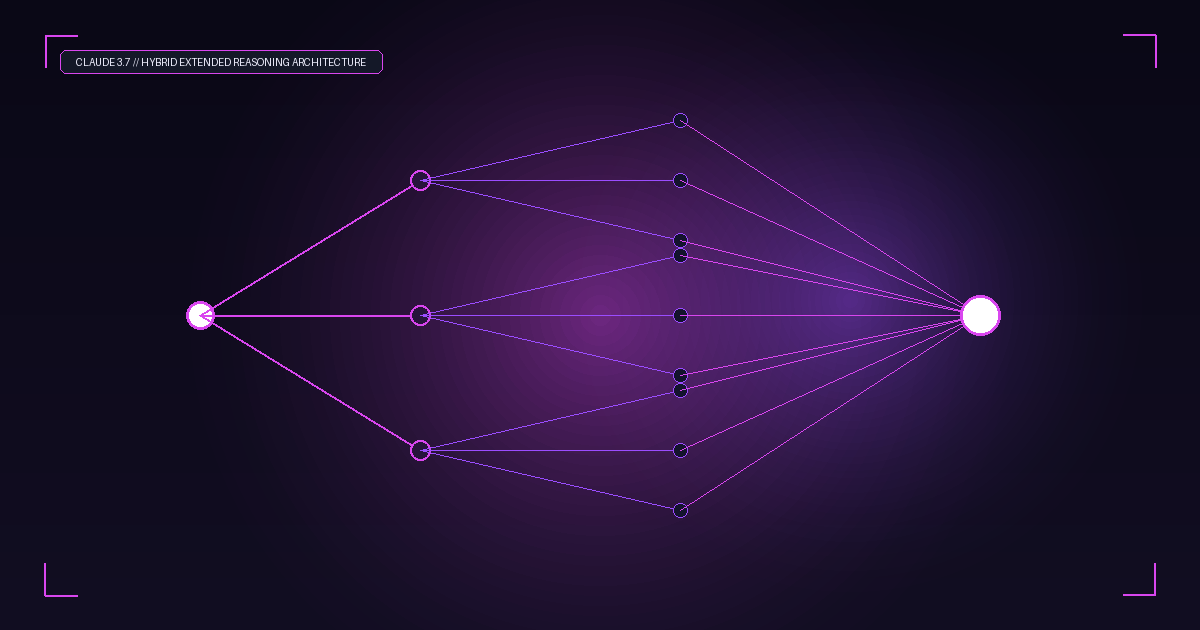
Durante la fase de pensamiento extendido, el modelo ejecuta una cadena lógica oculta donde evalúa hipótesis antagónicas, simula la ejecución del código en memoria y corrige inconsistencias antes de generar la respuesta final.
3. Implementación en la Ingeniería de Better2Better
En Better2Better incorporamos razonamiento híbrido en nuestros flujos de verificación continua. Aplicamos inferencia rápida para pruebas unitarias convencionales y activamos presupuestos profundos ante análisis criptográficos o arquitectónicos complejos.
4. Matriz de Configuración de Presupuestos de Pensamiento
| Escenario de Uso | Presupuesto Sugerido | Comportamiento del Sistema |
|---|---|---|
| APIs Web y Consultas UI | Desactivado / 0 tokens | Latencia mínima en milisegundos, streaming inmediato. |
| Refactorización de Software | 2.048 – 8.192 tokens | Análisis de tipado estricto, dependencias y pruebas integradas. |
| Auditoría de Smart Contracts | 16.384 – 32.768 tokens | Verificación de reentrancia y modelos de liquidez. |
| Arquitectura de Alta Escala | Hasta 64.000 tokens | Modelado de tolerancia a fallos y consistencia distribuida. |
5. Bibliografía y Referencias Técnicas
Documentos Oficiales y Publicaciones Científicas:
- Anthropic Technical Report (2025). Claude 3.7 Sonnet and the Emergence of Dynamic Hybrid Reasoning. Anthropic Publications.
- Wei, J., Wang, X., Schuurmans, D., et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS 2022, arXiv:2201.11903.
- Snell, C., Lee, J., Xu, K., & Kumar, A. (2024). Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Parameters. arXiv:2408.03314.
Garantía de Seguridad y Auditoría Criptográfica en Agentes de IA
Implementar agentes autónomos sin una arquitectura defensiva blindada representa el mayor riesgo operativo para una empresa. En Better2Better, nuestro equipo liderado por Felipe Siqueira y la Dra. Helena Vance audita a fondo cada flujo, aislando la memoria vectorial en sandboxes seguros y neutralizando vectores de inyección de prompts.
¿Qué podemos hacer por usted hoy?
¿Le gustó el contenido? ¡Cree su ecosistema de agentes autónomos de IA con blindaje de seguridad garantizado haciendo clic aquí!
🤖 Crear Agentes de IA por WhatsAppGarantía de Seguridad y Auditoría Criptográfica en Agentes de IA
Implementar agentes autónomos sin una arquitectura defensiva blindada representa el mayor riesgo operativo para una empresa. En Better2Better, nuestro equipo liderado por Felipe Siqueira y la Dra. Helena Vance audita a fondo cada flujo, aislando la memoria vectorial en sandboxes seguros y neutralizando vectores de inyección de prompts.
¿Qué podemos hacer por usted hoy?
¿Le gustó el contenido? ¡Cree su ecosistema de agentes autónomos de IA con blindaje de seguridad garantizado haciendo clic aquí!
🤖 Crear Agentes de IA por WhatsApp