Disaster Recovery Corporativo: RPO Zero e RTO Sub-Minuto em Arquiteturas Multi-Região Ativo-Ativo e Chaos Engineering
No cenário corporativo moderno de fintechs, exchanges, sistemas bancários e plataformas de comércio eletrônico de alta escala, o custo de uma hora de inatividade não é medido em milhares de dólares, mas em milhões de dólares de prejuízo imediato, danos irreparáveis à reputação da marca e sanções regulatórias severas. Alcançar RPO Zero (Zero Data Loss) e RTO Sub-Minuto (Recovery Time Objective < 60s) não é um luxo teórico: é o padrão de sobrevivência operacional que diferencia as lideranças de mercado.
🚀 Conheça a Solução Crypto as a Service (CaaS) Global da Better2Better
Potencialize sua operação cross-border com trilhos de pagamento globais de alta conversão: SWIFT, Pix, MB WAY, Mercado Pago e PayPal. Conte com liquidação garantida por parceiro homologado, API REST/WebSocket para integrar em qualquer ERP ou e-commerce, e conta com cartão de crédito cripto que transforma o saldo em criptoativos no limite de compras do cliente.
1. Desmistificando RPO e RTO: Os Pilares da Resiliência Distribuída
Muitos executivos e arquitetos confundem estratégias convencionais de backup e réplicas assíncronas com Disaster Recovery verdadeiro:
- RPO (Recovery Point Objective): Mede a quantidade máxima tolerável de dados perdidos durante um desastre. Um RPO de 15 minutos significa que 15 minutos de transações financeiras, depósitos ou compras foram perdidos para sempre. Para um banco ou exchange, o único RPO aceitável é exatamente ZERO.
- RTO (Recovery Time Objective): Mede o tempo decorrido entre a ocorrência do incidente catastrófico (queda total de uma região da AWS, GCP ou Azure) e o restabelecimento completo do serviço. No modelo Ativo-Ativo da Better2Better, o RTO é sub-minuto, ocorrendo de forma 100% automatizada.
Quadro Arquitetural: Modelos de Recuperação de Desastres
| Topologia de DR | RPO Esperado | RTO Real | Custo Operacional e Complexidade |
|---|---|---|---|
| Cold Standby (Backup & Restore) | 2 a 24 horas | 6 a 48 horas | Baixo custo, porém risco existencial em desastres |
| Warm Standby (Pilot Light) | 5 a 30 minutos | 15 a 60 minutos | Custo intermediário; exige scripts manuais de ativação |
| Ativo-Passivo (Hot Standby) | Alguns segundos a minutos | 2 a 10 minutos | Custo duplicado de infraestrutura com ociosidade |
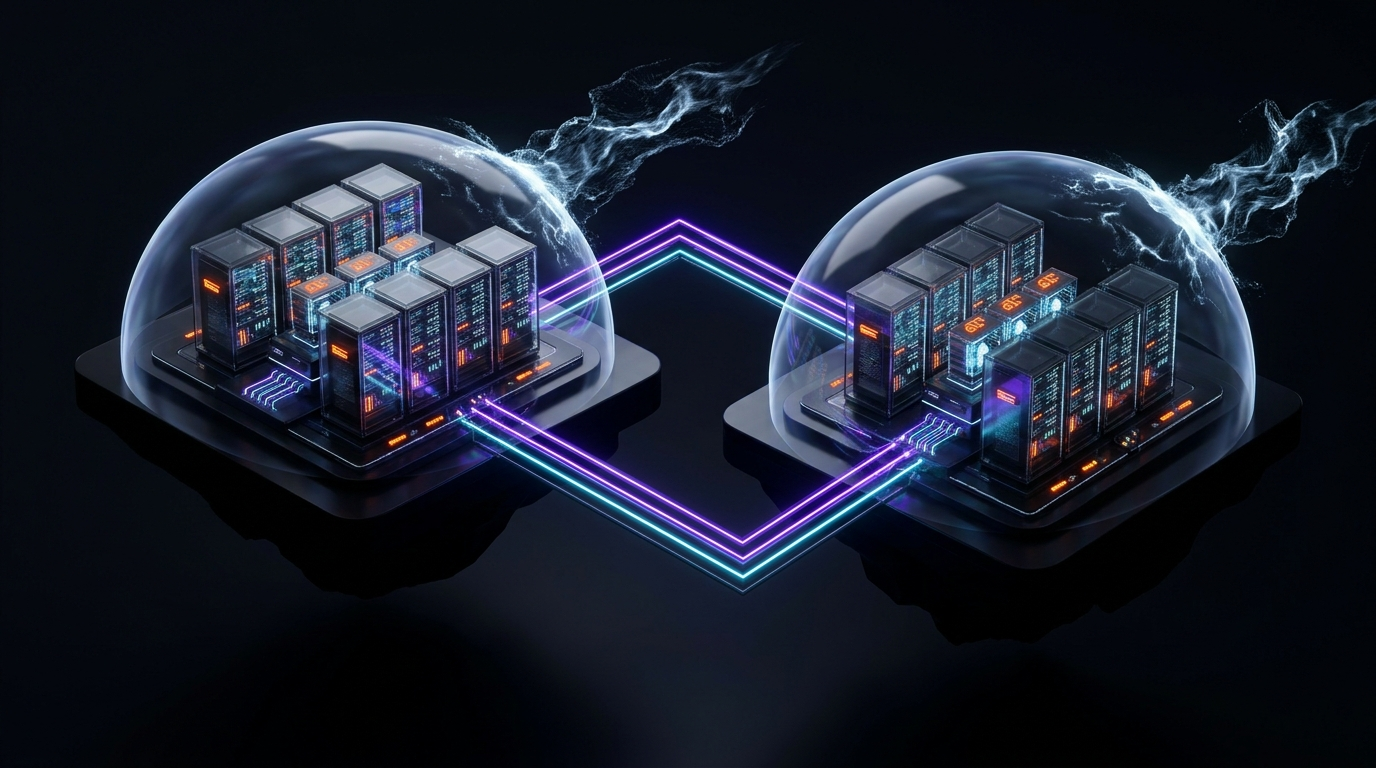
| Ativo-Ativo Multi-Região Better2Better | ZERO estrito (0s) | Sub-minuto (< 30s) | Eficiência máxima: ambas as regiões processam carga real contínua |
2. Replicação Síncrona e Consenso Distribuído: Raft e Paxos
Para atingir RPO=0 entre regiões geográficas distintas (por exemplo, São Paulo e Virgínia, ou Frankfurt e Dublin), a replicação de banco de dados não pode ser assíncrona. Se uma região falhar enquanto os dados estão no buffer de rede assíncrono, esses dados evaporam.
A Better2Better adota topologias baseadas em consenso distribuído Raft (com CockroachDB, Google Spanner ou etcd multi-região):
- Quórum de Gravação Multi-Região: Toda transação de escrita só é confirmada (commit) quando a maioria estrita (quórum
(N/2) + 1) dos nós distribuídos entre 3 zonas ou regiões diferentes confirma a persistência em disco seguro. - Tolerância a Perda de Região Inteira: Se uma região física inteira for desconectada da Internet ou destruída por uma falha de fornecimento elétrico, os nós remanescentes mantêm o quórum sem interrupção e sem perda de um único bit transacional.
- Mitigação de Split-Brain com Fencing Tokens: O sistema utiliza relógios atômicos híbridos (Hybrid Logical Clocks - HLC) e fencing tokens para garantir que nós isolados por partição de rede não aceitem escritas conflitantes.
3. Roteamento de Tráfego Global: Anycast BGP e GeoDNS com Health Checks Ativos
O failover de usuários de uma região para outra não pode depender de propagação DNS convencional (que leva minutos ou horas por causa de caches de ISPs agressivos). Nossa arquitetura emprega Anycast BGP na camada de rede:
- Um único endereço IP Anycast é anunciado por múltiplos Pontos de Presença (PoPs) ao redor do mundo.
- Se uma região de processamento backend falha nas sondagens de saúde (HTTP Health Checks em camada 7 com limiares rigorosos), os roteadores de borda retiram os anúncios BGP daquela rota em menos de 3 segundos.
- O tráfego dos clientes é redirecionado instantaneamente na camada de roteamento dos provedores de trânsito IP para a região sadia mais próxima, com perda zero de conexões TCP graças a TLS Session Resumption.
4. Chaos Engineering Contínuo: Quebrando a Produção Para Garantir a Imunidade
Uma arquitetura de Disaster Recovery que só é testada no dia do desastre real é uma ilusão. A engenharia da Better2Better integra testes contínuos de Chaos Engineering automatizados via Chaos Mesh e LitmusChaos:
Simulamos rotineiramente a perda súbita de 50% dos pods Kubernetes, desconexão forçada de links de fibra óptica inter-regionais e corrupção sintética de tabelas em ambientes canary. Se o sistema não se recuperar de forma 100% autônoma em menos de 45 segundos, a esteira de CI/CD é imediatamente bloqueada.
5. Código Completo: Provedor de Health Check e Failover em Go
Abaixo apresentamos um exemplo de monitor de saúde regional de alta precisão que coordena o desacoplamento de rotas BGP:
package main

import (
	"context"
	"fmt"
	"net/http"
	"os"
	"sync/atomic"
	"time"
)

type RegionHealthCoordinator struct {
	isHealthy    int32 // atomic bool
	checkTimeout time.Duration
	regionName   string
}

func (r *RegionHealthCoordinator) ProbeDatabaseQuorum(ctx context.Context) bool {
	// Simula checagem de quórum Raft regional
	ctx, cancel := context.WithTimeout(ctx, r.checkTimeout)
	defer cancel()

	done := make(chan bool, 1)
	go func() {
		// Verificação de conectividade com nós pares da região
		done <- true
	}()

	select {
	case <-ctx.Done():
		return false
	case ok := <-done:
		return ok
	}
}

func (r *RegionHealthCoordinator) RunHealthLoop(ctx context.Context) {
	ticker := time.NewTicker(2 * time.Second)
	defer ticker.Stop()

	for {
		select {
		case <-ctx.Done():
			return
		case <-ticker.C:
			ok := r.ProbeDatabaseQuorum(ctx)
			if ok {
				atomic.StoreInt32(&r.isHealthy, 1)
			} else {
				atomic.StoreInt32(&r.isHealthy, 0)
				fmt.Printf("[ALERTA CRÍTICO] Quórum perdido na região %s. Desativando anúncios BGP!\n", r.regionName)
				// Executa chamada de retirada de rota BGP via API do roteador
			}
		}
	}
}

func main() {
	coordinator := &RegionHealthCoordinator{
		isHealthy:    1,
		checkTimeout: 500 * time.Millisecond,
		regionName:   "sa-east-1",
	}
	go coordinator.RunHealthLoop(context.Background())
	http.HandleFunc("/healthz", func(w http.ResponseWriter, r *http.Request) {
		if atomic.LoadInt32(&coordinator.isHealthy) == 1 {
			w.WriteHeader(http.StatusOK)
			w.Write([]byte("REGION_ACTIVE"))
		} else {
			w.WriteHeader(http.StatusServiceUnavailable)
			w.Write([]byte("REGION_DEGRADED"))
		}
	})
	http.ListenAndServe(":8080", nil)
}
6. Checklist de Implementação de Disaster Recovery Ativo-Ativo
- [x] Banco de dados distribuído configurado com replicação síncrona em 3 regiões independentes.
- [x] Roteamento de borda Anycast BGP com remoção automática de nós degradados em < 5s.
- [x] Testes automatizados de Chaos Engineering executados semanalmente em ambiente staging e produção canary.
- [x] Playbooks de emergência automatizados sem necessidade de decisão humana durante o failover.
- [x] Métricas de lag de replicação monitoradas com alarmes PagerDuty em tempo real.
7. Perguntas Frequentes sobre Disaster Recovery Corporativo (FAQ)
❓ O que significa ter RPO Zero e RTO Sub-Minuto na prática?
RPO Zero significa que em caso de queda catastrófica de um datacenter ou região inteira, absolutamente nenhuma transação confirmada é perdida. RTO Sub-Minuto significa que o sistema redireciona todo o tráfego e restaura a operação plena em menos de 60 segundos de forma automática.
❓ Como a arquitetura Ativo-Ativo difere do modelo tradicional de cópia de segurança (backup)?
No modelo tradicional com backup, você precisa restaurar arquivos e esperar horas para reconstruir servidores com dados defasados. No Ativo-Ativo, múltiplas regiões processam clientes reais simultaneamente. Se uma região cai, as outras já estão operacionais e absorvem a carga em segundos.
❓ Qual banco de dados é capaz de garantir RPO Zero entre regiões distantes?
Utilizamos sistemas de bancos de dados relacionais distribuídos baseados em consenso Raft, como CockroachDB, YugabyteDB ou Google Cloud Spanner, que só concluem transações após a gravação síncrona em quórum multi-região.
❓ A latência da replicação síncrona entre cidades distantes não torna o sistema lento?
Com otimizações modernas de batching, pipelines em Rust/Go e conexões dedicadas de fibra óptica (interconnects privados com latência de ida e volta inferior a 25ms), a latência adicional percebida pelos usuários finais é imperceptível (< 30ms).
❓ O que é o risco de Split-Brain e como o sistema o previne?
Split-Brain ocorre quando duas regiões perdem comunicação entre si e ambas acham que a outra morreu, passando a aceitar dados conflitantes. Nossa arquitetura impede isso utilizando número ímpar de regiões com quórum estrito da maioria (Raft) e tokens de isolamento criptográfico.
❓ Por que o DNS tradicional não é adequado para failover sub-minuto?
Porque servidores DNS de provedores de Internet frequentemente ignoram o TTL (Time-to-Live) baixo e mantêm caches antigos por horas. Por isso usamos Anycast BGP na camada de roteamento IP, que propaga rotas em menos de 3 segundos.
❓ O que é Chaos Engineering e por que é obrigatório em sistemas críticos?
É a disciplina de injetar falhas reais intencionalmente em produção (como derrubar servidores, simular lentidão de rede e corromper pacotes) para provar empiricamente que os mecanismos automáticos de resiliência funcionam antes que um incidente real aconteça.
❓ Qual é a economia financeira de operar uma arquitetura Ativo-Ativo?
Além de evitar multas milionárias e perda de clientes por indisponibilidade, no Ativo-Ativo você não tem hardware ocioso esperando um desastre: toda a infraestrutura contratada trabalha continuamente gerando receita.
❓ Como a plataforma atende às exigências de continuidade de negócios de órgãos reguladores?
Nossos relatórios de testes de estresse, evidências de replicação contínua e certificações atendem integralmente à Resolução BCB 85 sobre segurança cibernética e continuidade de negócios no sistema financeiro.
❓ Como a Better2Better pode estruturar o Disaster Recovery da minha empresa?
Nossa equipe sênior de infraestrutura e SRE realiza uma auditoria completa de resiliência da sua stack, desenha a topologia Ativo-Ativo e implanta a automação de failover com testes de caos em menos de 30 dias.
Pronto para Construir ou Escalar Sua Arquitetura Corporativa?
Fale diretamente com nossos arquitetos de software e engenheiros especialistas. Analisamos seus requisitos técnicos, fornecemos o blueprint completo e implementamos software pronto para produção com SLAs rigorosos e segurança Zero-Trust.