Disaster Recovery Corporativo: RPO Cero y RTO Sub-Minuto en Arquitecturas Multi-Región Activo-Activo y Chaos Engineering
En el entorno corporativo moderno de fintechs, bancos digitales y comercio electrónico de alta demanda, el coste de una hora de inactividad no se mide en miles, sino en millones de dólares de pérdidas directas, deterioro irreversible de la reputación de marca y severas sanciones regulatorias. Garantizar RPO Cero (Zero Data Loss) y RTO Sub-Minuto (Recovery Time Objective < 60s) es el estándar operativo que distingue a las empresas líderes de las arquitecturas vulnerables.
🚀 Descubre la Plataforma Global Crypto as a Service (CaaS) de Better2Better
Acelera tus operaciones corporativas internacionales con rieles financieros globales listos para producción: SWIFT, Pix, MB WAY, Mercado Pago y PayPal. Respaldado por un socio regulado de liquidación de activos, API REST/WebSocket universal para cualquier sistema o tienda virtual, y cuenta con tarjeta de crédito cripto que utiliza activos digitales como límite de crédito.
1. Desmitificando RPO y RTO: Métricas de Supervivencia Distribuida
Es frecuente confundir las copias de seguridad convencionales con un auténtico Disaster Recovery:
- RPO (Recovery Point Objective): Mide la cantidad máxima admisible de datos perdidos ante un desastre. Un RPO de 15 minutos implica perder para siempre 15 minutos de pagos y transacciones. Para un banco o exchange, el único valor admisible es estrictamente CERO.
- RTO (Recovery Time Objective): Tiempo transcurrido desde la caída de una infraestructura hasta el restablecimiento completo del servicio. Con la arquitectura Activo-Activo de Better2Better, el RTO es sub-minuto (< 30s) de manera 100% automatizada.
Comparativa de Modelos de Disaster Recovery
| Topología | RPO Estimado | RTO Real | Eficiencia Operativa |
|---|---|---|---|
| Cold Standby (Backup tradicional) | 2 a 24 horas | 6 a 48 horas | Bajo coste, pero riesgo existencial crítico |
| Warm Standby (Pilot Light) | 5 a 30 minutos | 15 a 60 minutos | Coste medio; sujeto a procesos manuales |
| Activo-Pasivo (Hot Standby) | Segundos a minutos | 2 a 10 minutos | Coste duplicado con infraestructura ociosa |
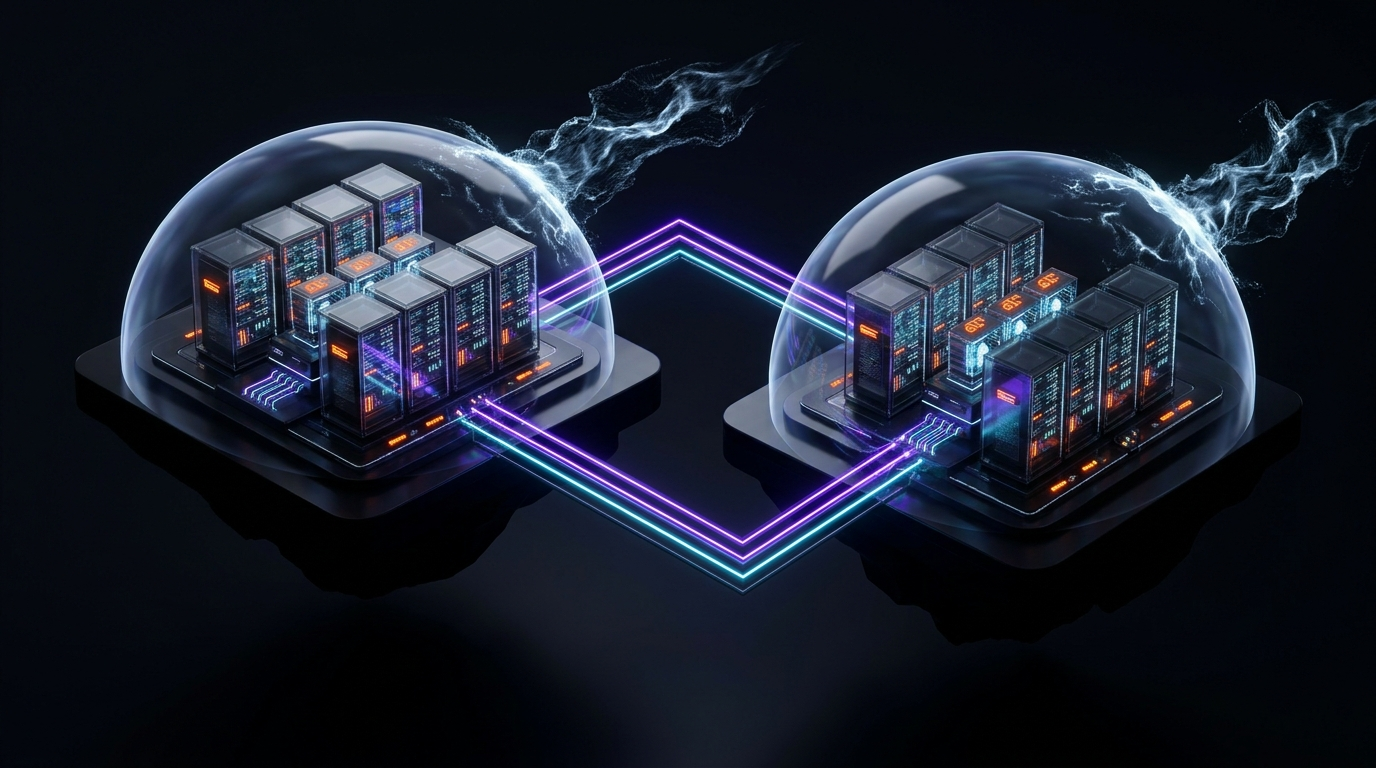
| Activo-Activo Multi-Región Better2Better | CERO estricto (0s) | Sub-minuto (< 30s) | Eficiencia máxima: todas las regiones procesan tráfico real |
2. Replicación Síncrona y Consenso Distribuido: Raft y Paxos
Lograr RPO=0 entre regiones geográficas distantes exige replicación síncrona basada en consenso:
- Quórum de Escritura Multi-Región: Las transacciones solo se confirman cuando la mayoría estricta (
(N/2) + 1) de los nodos distribuidos en 3 regiones físicas ratifica la escritura. - Inmunidad ante Caída de Región: Si una región completa colapsa, los nodos restantes sostienen el quórum sin perder un solo bit.
- Prevención de Split-Brain con Tokens de Aislamiento: Empleamos relojes lógicos híbridos (HLC) para evitar inconsistencias en particiones de red.
3. Ruteo Global con Anycast BGP y Sondas en Capa 7
El failover no puede depender de la propagación DNS. Empleamos Anycast BGP en la capa de red para retirar anuncios de rutas degradadas en menos de 3 segundos, redirigiendo el tráfico sin latencia añadida.
4. Pruebas Continuas de Chaos Engineering en Producción
Inyectamos periódicamente fallos reales (caídas de nodos, latencias inducidas y pérdidas de paquetes) en entornos de staging y canary mediante Chaos Mesh, demostrando que la recuperación automática opera con éxito antes de una incidencia real.
5. Implementación en Go: Monitor de Salud Regional y Conmutación
Ejemplo de monitor de salud para retirada automática de rutas BGP:
package main

import (
	"context"
	"fmt"
	"net/http"
	"sync/atomic"
	"time"
)

type RegionHealthCoordinator struct {
	isHealthy    int32
	checkTimeout time.Duration
	regionName   string
}

func (r *RegionHealthCoordinator) ProbeDatabaseQuorum(ctx context.Context) bool {
	ctx, cancel := context.WithTimeout(ctx, r.checkTimeout)
	defer cancel()

	done := make(chan bool, 1)
	go func() {
		done <- true
	}()

	select {
	case <-ctx.Done():
		return false
	case ok := <-done:
		return ok
	}
}

func (r *RegionHealthCoordinator) RunHealthLoop(ctx context.Context) {
	ticker := time.NewTicker(2 * time.Second)
	defer ticker.Stop()

	for {
		select {
		case <-ctx.Done():
			return
		case <-ticker.C:
			if r.ProbeDatabaseQuorum(ctx) {
				atomic.StoreInt32(&r.isHealthy, 1)
			} else {
				atomic.StoreInt32(&r.isHealthy, 0)
				fmt.Printf("[ALERTA CRITICA] Perdida de quorum en %s. Retirando rutas BGP!\n", r.regionName)
			}
		}
	}
}

func main() {
	coordinator := &RegionHealthCoordinator{
		isHealthy:    1,
		checkTimeout: 500 * time.Millisecond,
		regionName:   "eu-west-1",
	}
	go coordinator.RunHealthLoop(context.Background())
	http.HandleFunc("/healthz", func(w http.ResponseWriter, r *http.Request) {
		if atomic.LoadInt32(&coordinator.isHealthy) == 1 {
			w.WriteHeader(http.StatusOK)
			w.Write([]byte("REGION_ACTIVE"))
		} else {
			w.WriteHeader(http.StatusServiceUnavailable)
			w.Write([]byte("REGION_DEGRADED"))
		}
	})
	http.ListenAndServe(":8080", nil)
}
6. Checklist Operativo para Disaster Recovery Activo-Activo
- [x] Clúster de base de datos distribuido en 3 regiones físicas con consenso Raft síncrono.
- [x] Ruteo perimetral Anycast BGP con desconexión de rutas degradadas en menos de 5s.
- [x] Simulaciones semanales de Chaos Engineering en entornos controlados.
- [x] Playbooks de emergencia totalmente automatizados sin intervención humana.
- [x] Monitorización en tiempo real de lag de replicación con alertas escaladas a PagerDuty.
7. Preguntas Frecuentes sobre Disaster Recovery Corporativo (FAQ)
❓ ¿Qué significa RPO Cero y RTO Sub-Minuto en el entorno operativo?
RPO Cero significa que ante la pérdida de un centro de datos completo, no se pierde ninguna transacción confirmada. RTO Sub-Minuto significa que el servicio se restablece al 100% de capacidad en menos de 60 segundos de forma automática.
❓ ¿Qué diferencia al modelo Activo-Activo frente al de copias de seguridad?
Las copias de seguridad exigen horas para reconstruir datos atrasados. En Activo-Activo, varias regiones atienden usuarios simultáneamente; si una falla, las restantes absorben el tráfico al instante.
❓ ¿Qué bases de datos garantizan RPO Cero entre regiones distantes?
Motores relacionales distribuidos con consenso Raft o Paxos, como CockroachDB, YugabyteDB o Google Cloud Spanner, que confirman transacciones únicamente tras validar quórum multi-región.
❓ ¿Afecta la replicación síncrona a la latencia percibida por el usuario?
Con interconexiones privadas de fibra óptica con tiempos de ida y vuelta inferiores a 25ms y pipelines optimizados, la latencia adicional es imperceptible (< 30ms).
❓ ¿Qué es el riesgo de Split-Brain y cómo se neutraliza?
Ocurre cuando regiones aisladas por una partición de red aceptan escritas contradictorias. Lo neutralizamos empleando un número impar de regiones con quórum mayoritario estricto y tokens criptográficos.
❓ ¿Por qué el DNS tradicional no es apto para recuperaciones sub-minuto?
Los servidores DNS de proveedores ignoran frecuentemente TTLs bajos y retienen cachés durante horas. Anycast BGP actualiza las rutas a nivel de protocolo IP en menos de 3 segundos.
❓ ¿Por qué es obligatorio el Chaos Engineering en entornos de misión crítica?
Inyecta deliberadamente averías reales para comprobar que los sistemas de failover automático operan antes de que surja una catástrofe imprevista.
❓ ¿Qué ahorro económico ofrece una infraestructura Activo-Activo?
Además de evitar multas y pérdidas operacionales millonarias, toda la infraestructura contratada procesa tráfico de forma productiva sin mantener servidores ociosos.
❓ ¿Cómo cumple la arquitectura las normativas bancarias de continuidad?
Nuestras auditorías de estrés y evidencias de replicación continua satisfacen plenamente las exigencias regulatorias de ciberseguridad y continuidad del negocio.
❓ ¿Cómo implementar una arquitectura Activo-Activo con Better2Better?
Contacte con nuestro equipo de SRE mediante WhatsApp o correo corporativo. Realizamos una auditoría de resiliencia y desplegamos la solución en menos de 30 días.
¿Listo para Construir o Escalar su Arquitectura Corporativa?
Hable directamente con nuestros arquitectos de software e ingenieros fintech jefe. Evaluamos su caso técnico, diseñamos diagramas de arquitectura y desplegamos sistemas listos para producción con garantía de seguridad Zero-Trust.